О проекте
Десктоп-приложение на Python для массового сжатия PDF-файлов. Гибридный алгоритм с тремя режимами: Ghostscript (скорость), Tesseract OCR (сканы), комбинированный с предварительным анализом страниц. Сокращает объём файлов на 60–80% без потери качества, ведёт историю обработки в SQLite, поддерживает п
Что это
Recursive PDF Compressor Pro — настольное приложение с графическим интерфейсом, которое решает одну конкретную и очень болезненную задачу: массовое сжатие PDF-файлов в промышленных объёмах. Не «попробовать одну кнопку», а обработать сотни документов за ночь, ничего не потеряв, ничего не повторив, оставив полный след для аналитики.
Программа работает в трёх режимах:
Ghostscript — быстрое сжатие с настройкой качества (для обычных PDF).
Tesseract OCR — распознавание и пересборка сканированных документов (когда без OCR теряется текстовый слой).
Комбинированный — предварительный анализ страниц определяет, что перед нами: чистый текст, скан или смешанный документ, и выбирает оптимальный путь обработки.
Как это работает
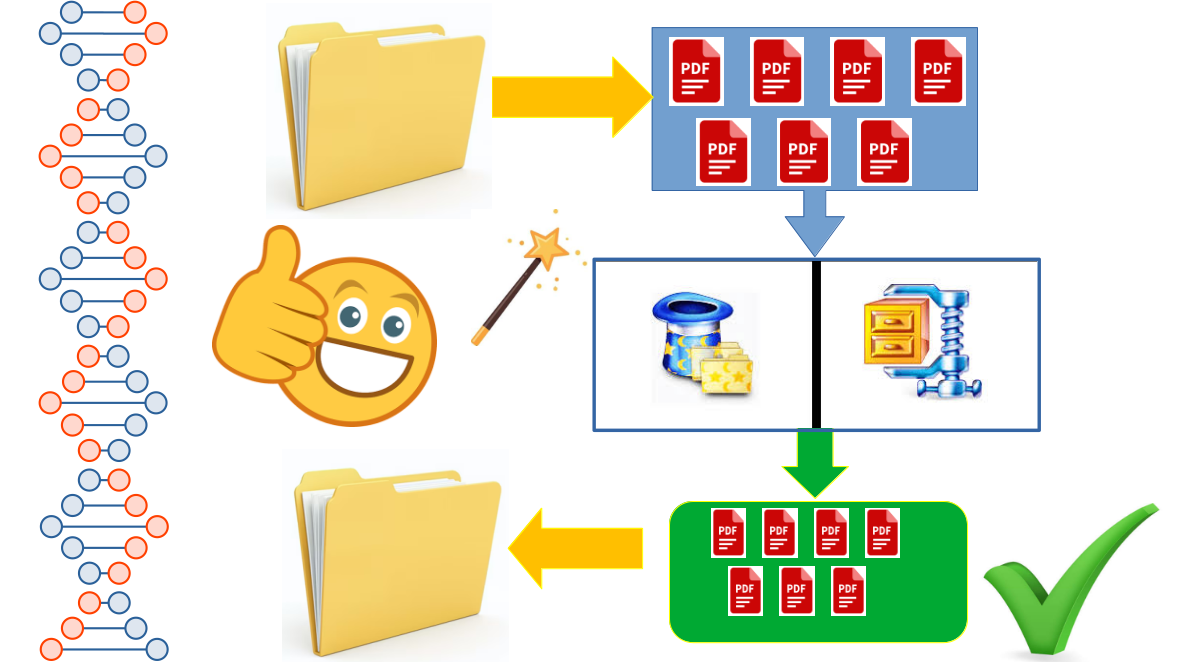
Пользователь указывает папку или список файлов, выбирает пресет (сохранённый набор параметров) и запускает обработку. Программа:
Сканирует директорию рекурсивно, включая сетевые пути.
Анализирует каждый файл — считает средний размер страницы, число страниц, определяет тип содержимого.
Пропускает заведомо компактные файлы — если PDF уже сжат достаточно хорошо, обработка не запускается. Причина сохраняется в лог: «пропущен, средний размер страницы ниже порога».
Обрабатывает в фоне, не блокируя интерфейс. Можно работать с другими задачами, пока идёт сжатие.
Записывает результат в SQLite: исходный размер, число страниц, использованный пресет, итоговый размер, время обработки, статус.
Ведёт лог с ротацией — старые записи автоматически архивируются, диск не забивается.
Что решает
Экономит время. Обработка сотен файлов идёт без участия оператора. Можно запустить вечером, утром получить результат и отчёт.
Экономит место. 60–80% сокращения объёма — это гигабайты, которые не нужно покупать в облаке или перекладывать на внешние диски.
Не тратит ресурсы на уже сжатые файлы. Если PDF весит 200 КБ и в нём всё в порядке, нечего его трогать. Программа это понимает сама.
Даёт аналитику. В любой момент можно посмотреть: сколько страниц обработано всего, средний размер, коэффициент сжатия по каждому пресету, какие файлы пропущены и почему.
Работает без интернета. Всё локально, никаких облачных сервисов, никакой утечки документов.
Для кого
Организации, работающие с большими архивами сканированных документов (медицина, юриспруденция, бухгалтерия, образование).
Отделы, которые готовят документы к отправке или публикации и сталкиваются с ограничениями по размеру.
Все, у кого на диске лежат тысячи PDF и жалко места, но нет времени возиться с каждым вручную.
Кроссплатформенность
Работает на Windows 7, Windows 10, Linux, macOS. Поддерживает сетевые пути, устойчива к «грязным» именам файлов. Требования к «железу» — минимальные: приложение не требует мощной машины, потому что узкие места делегированы проверенным движкам (Ghostscript, Tesseract, Poppler).
Установка и сопровождение
Есть два варианта:
Исходники + инструкция. Вы получаете код и подробную инструкцию по установке — разворачиваете сами или силами своего IT-специалиста.
Установка под ключ. Я подключаюсь, устанавливаю и настраиваю программу на рабочий компьютер. В стоимость входит до 3 бесплатных донастроек — если антивирус «зачистит» компонент или потребуется адаптация под конкретную среду.
Есть также вариант полной передачи прав — единоразовый платёж, условия обсуждаются индивидуально.
Почему это работает именно так
Программа не пытается быть «умнее» польз�ователя. Она не удаляет файлы, не перезаписывает оригиналы без спроса, не требует подключения к облаку. Задача была — сделать надёжный инструмент, который не мешает и не подводит. Именно поэтому в трёх организациях приложение используется штатными сотрудниками без моего участия — «настроил и забыл».
Стек и ссылки
Статус: Завершён · 09.2026 — 09.2026
Задача
Разработать настольное приложение для массового сжатия PDF-файлов, пригодное для работы в организациях с большими архивами документов. Требования:
Работа с сотнями файлов без участия оператора.
Три режима обработки: быстрое сжатие, OCR для сканов, комбинированный с предварительным анализом.
Отсеивание файлов, которые не нуждаются в обработке.
Полная история обработки для аналитики.
Многопоточность — интерфейс не должен блокироваться.
Кроссплатформенность: Windows, Linux, macOS.
Поддержка сетевых путей.
Минимальные требования к «железу».
Стабильность при работе с «грязными» именами файлов и большими объёмами.
Дополнительно: система пресетов, защита от повторной обработки, автоматическое логирование с ротацией, резервное копирование базы данных.
Решение
Архитектура
Приложение построено по модульному принципу: отдельно ядро обработки, отдельно GUI, отдельно слой хранения, отдельно интеграция с внешними движками. Это позволяет менять движки и настройки без переписывания логики целиком.
Гибридный алгоритм сжатия
Ghostscript — базовый быстрый режим. Позволяет задать уровень качества и получить результат за секунды на файл.
Tesseract OCR — для сканированных PDF: распознаёт текстовый слой, пересобирает документ с сохранением читаемости.
Комбинированный — перед обработкой проводится анализ страниц (через PyPDF2 и Poppler): определяется средний размер страницы, наличие текстового слоя, признаки скана. По результатам выбирается оптимальный путь.
Предварительный анализ и отсев
Перед обработкой каждый файл оценивается:
средний размер страницы;
общее число страниц;
наличие/отсутствие текстового слоя;
тип содержимого (чистый текст / скан / смешанный).
Если файл уже компактный — он пропускается. Причина пропуска фиксируется в логе. Это исключает бесполезную нагрузку на процессор и защищает от «сжатия того, что и так сжато».
Многопоточность
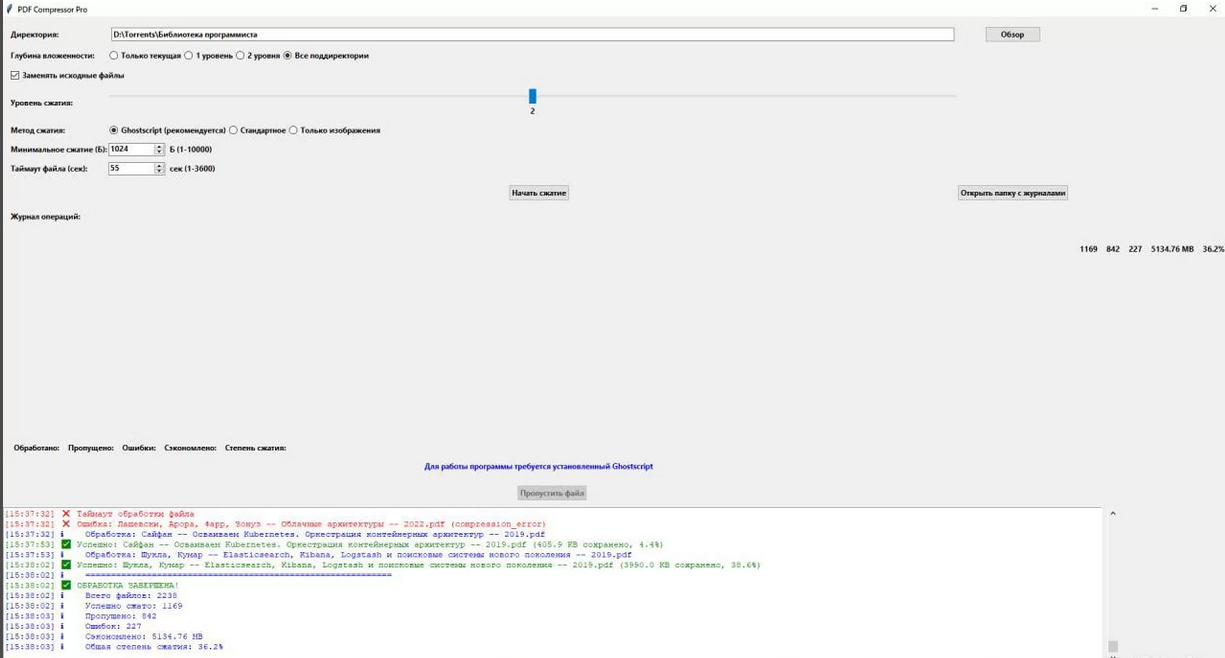
Обработка идёт в фоновом потоке (threading). Интерфейс остаётся отзывчивым: можно добавлять новые задачи, смотреть лог, переключать пресеты, пока текущие файлы обрабатываются. Прогресс отображается в реальном времени.
База данных и аналитика
Всё пишется в SQLite: исходный и итоговый размер, число страниц, использованный пресет, время обработки, статус. На этой базе строится аналитика:
общее число обработанных страниц;
средний размер файла до и после;
коэффициент сжатия по каждому пресету;
список пропущенных файлов с причинами.
Есть автоматическое резервное копирование базы.
Система пресетов
Пользователь настраивает параметры сжатия и сохраняет их как пресет. Пресеты переключаются одним кликом — не нужно каждый раз вспоминать оптимальные настройки. Каждый пресет учитывается в статистике отдельно.
Защита от повторной обработки
Каждый обработанный файл фиксируется в базе. При повторном запуске сканирования программа видит, что файл уже обработан, и не трогает его. Это экономит время оператора и ресурсы компьютера.
Логирование
Логи пишутся автоматически и ротируются: старые архивируются, диск не переполняется. В логе — все события: старт обработки, пропуски, ошибки, результаты, длительность. По логу можно восстановить любую операцию.
GUI
Tkinter — выбран осознанно: он входит в стандартную библиотеку Python, не требует внешних зависимостей и работает на всех целевых платформах. Интерфейс простой: список файлов, кнопки запуска, выбор пресета, окно лога, панель статистики.
Работа с внешними движками
Ghostscript, Tesseract и Poppler подключаются через subprocess. Это даёт гибкость: движки можно обновлять независимо от приложения, а ошибки внешних компонентов не валят всё приложение — они перехватываются и логируются.
Кроссплатформенность
Код не использует платформо-зависимых вызовов. Пути обрабатываются через pathlib. Сетевые пути поддерживаются — можно указать UNC-путь в Windows или смонтированную сетевую папку в Linux.
Бэкапы
Автоматическое резервное копирование SQLite-базы: при каждом запуске создаётся дамп, старые ротируются. Данные не теряются даже при сбое.
Результаты
Исключена повторная обработка — каждому файлу присваивается статус «обработан», повторный запуск пропускает такие файлы.
Полная аналитика: общее число страниц, средний размер до и после, коэффициент сжатия по пресетам, количество пропущенных файлов с причинами.
Интерфейс не блокируется — обработка идёт в фоне, оператор может работать параллельно.
Кроссплатформенность: Windows 7, Windows 10, Linux, macOS.
Поддержка сетевых путей — работает с файлами на общих дисках и в смонтированных папках.
Минимальные требования к «железу» — приложение не требует мощной машины, всю тяжёлую работу делают проверенные движки.
Внедрено в трёх организациях, эксплуатируется штатными сотрудниками без участия разработчика.
Работает автономно — не требует интернета, облачных сервисов, постоянного сопровождения.
Логи с ротацией — диагностика возможна в любой момент, диск не переполняется.
Бэкапы базы — данные не теряются при сбоях.
Мой вклад
Единоличная разработка полного цикла:
Архитектура — проектирование модульной структуры, разделение ядра, GUI, хранилища и интеграций.
Интеграция внешних движков — Ghostscript, Tesseract OCR, Poppler через subprocess, обработка ошибок и таймаутов.
Гибридный алгоритм — логика выбора режима обработки на основе анализа страниц (PyPDF2 + Poppler).
GUI — интерфейс на Tkinter: список файлов, пресеты, прогресс, лог, панель статистики.
Многопоточность — фоновая обработка без блокировки интерфейса.
Аналитика — схема SQLite, сбор статистики, отчёты по пресетам и по пропущенным файлам.
Система пресетов — сохранение, переключение, учёт в статистике.
Логирование с ротацией — автоматические логи, архивация старых.
Защита от повторов — фиксация обработанных файлов в базе.
Бэкап БД — автоматическое резервное копирование SQLite.
Установка и дистанционная настройка через AnyDesk.
Тестирование на Windows 7 и Windows 10, проверка на «грязных» данных и больших архивах.
Сопровождение — до 3 бесплатных донастроек на каждый экземпляр.
Приложение внедрено в трёх организациях и обслуживается штатными сотрудниками без моего участия.
Скриншоты